Jev vs. Laya: la revancha — el modelo comercial "System One" anotó 70% contra mis finanzas (y lo que cuesta esa victoria)
El hype, otra vez
La historia del mes en IA de decisiones tiene dos protagonistas. Por un lado Laya, el modelo open-source de 421M que desplegué en mi propio servidor y que perdió 18 a 2 contra las finanzas de mi familia. Por el otro, Jev, el modelo comercial de TypeSafe AI contra el que Laya se comparaba en su propio lanzamiento — 7.8× más lento y de pago, según el benchmark que viralizó al underdog.
Cuando TypeSafe abrió una ventana de acceso gratuito a la API de Jev, no dudé: mismo set de 20 transacciones reales, mismas reglas, cero cherry-picking. La revancha se mide en la misma cancha.
Para el contexto del sistema — el Family Wealth Command Center, NocoDB con las finanzas familiares, el agente Hermes por Telegram, la taxonomía de 56 categorías personalizadas en español — lean primero el artículo de Laya. Todo lo que sigue usa exactamente la misma metodología.
El experimento
Laya se ahogó con mi taxonomía: 56 opciones superaban su límite práctico (~20 por pregunta), así que tuve que implementar el patrón jerárquico dimensión → categoría, con una llamada por nivel. Jev no tiene ese problema: su primitiva choice acepta hasta 255 opciones. Eso permitió probar algo que con Laya era imposible: una sola pregunta plana con las 57 categorías reales, en español, con un state mínimo ("Transacción de gasto familiar en Perú. Concepto/Monto/Moneda/Cuenta/Notas").
Las reglas no cambiaron: las mismas 20 transacciones de tipo "Gasto" ya categorizadas por mí (ground truth), sin revelarle la categoría real, midiendo match exacto de categoría, latencia y confianza reportada. Y como Jev también acepta el patrón jerárquico, lo corrí en ambos modos para comparar manzanas con manzanas.
Una nota de rigor antes de los números: dos filas del ground truth tenían mojibake heredado (el carácter de reemplazo �, resto de una codificación rota) en el nombre de la categoría. Los normalicé contra la tabla limpia de categorías antes de medir; sin esa corrección el marcador hubiera sido 12/20, corregido y justo es 14/20. Moraleja incómoda: Jev devolvía las tildes correctas incluso cuando mi propia base de datos ya no las tenía. Y ese mojibake resultó ser síntoma de un bug de codificación en mi pipeline de escritura hacia NocoDB — que ya está en la lista de investigación. Los benchmarks baratos siempre pagan con intereses.
Los resultados
| Configuración | Exactitud categoría | Exactitud dimensión | Latencia prom. | Conf. media en aciertos | Conf. media en fallos | Costo por decisión |
|---|---|---|---|---|---|---|
| Laya zero-shot | 10% (2/20) | n/d | ~900 ms (CPU local) | 0.72–0.78 | ~0.3 | $0 |
| Laya few-shot | 5% (1/20) | n/d | ~1000 ms (CPU local) | n/d | n/d | $0 |
| Jev plano | 70% (14/20) | 80% (16/20) | ~599 ms (547–718) | 0.90 | 0.34 | ~$0.0004 |
| Jev jerárquico | 50% (10/20) | 60% (12/20) | ~1169 ms | 0.96 | 0.53 | ~$0.0008 |
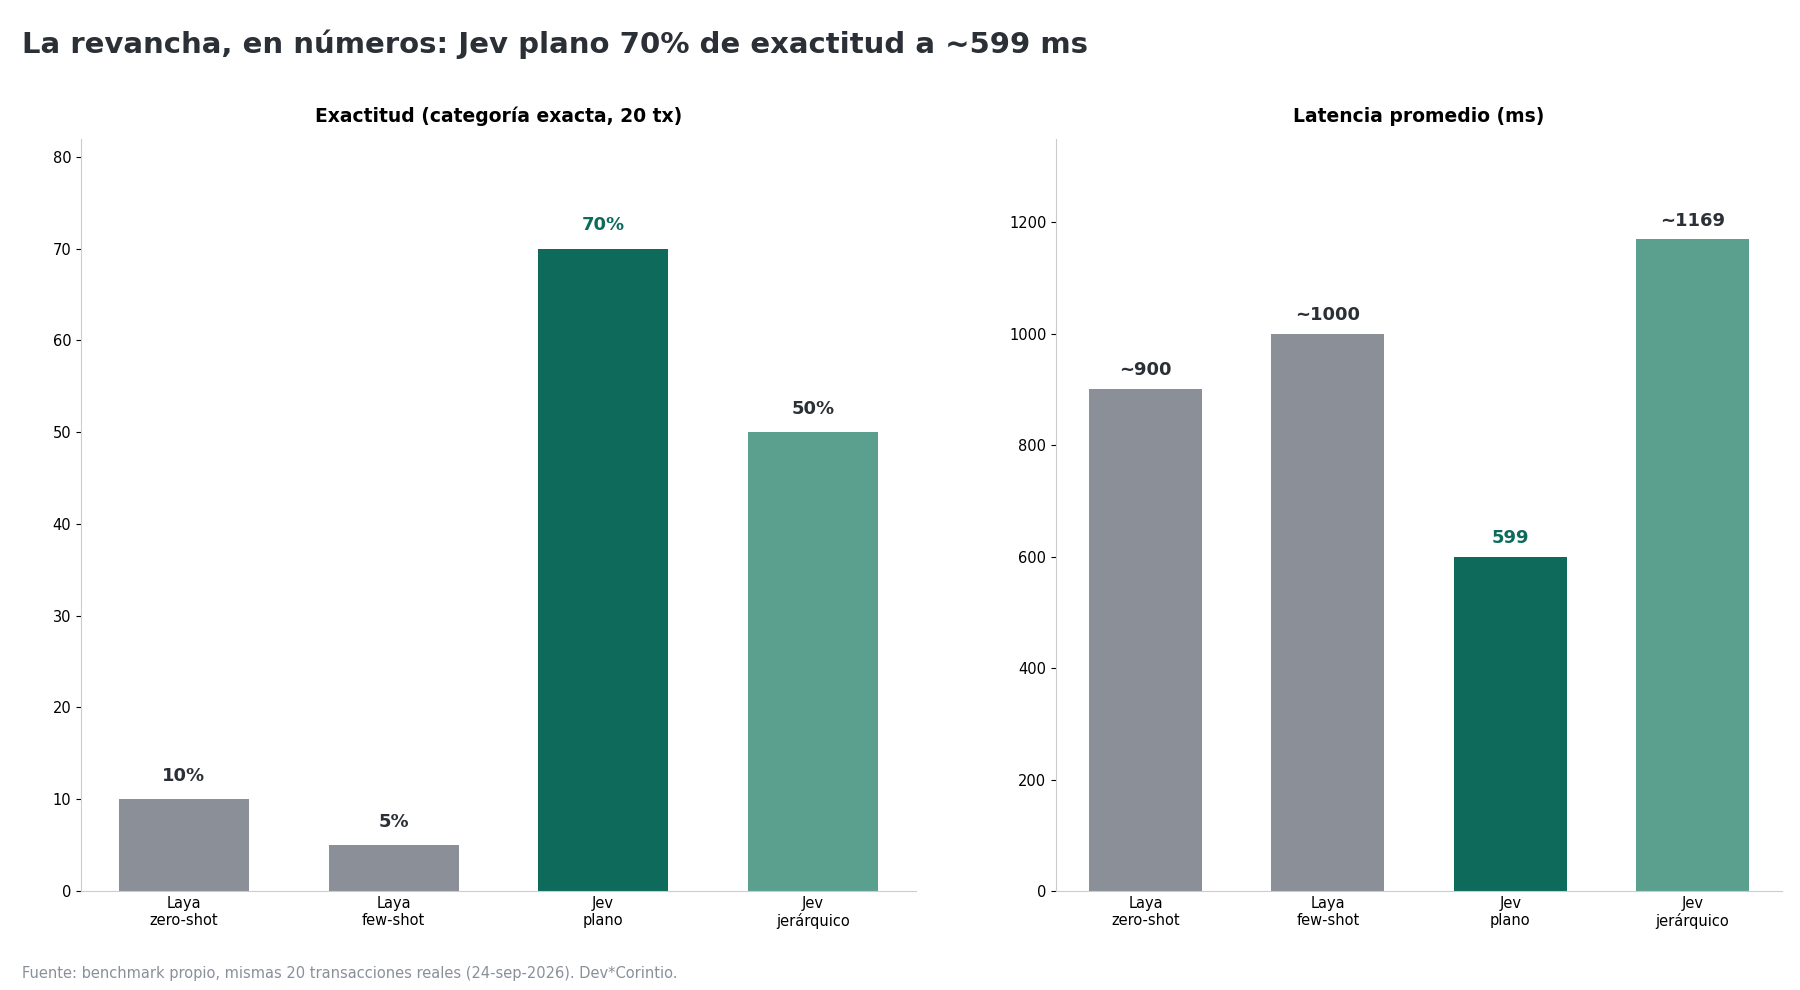
Setenta por ciento. Siete veces la exactitud de Laya en la misma tarea, con dos tercios de la latencia y una arquitectura trivialmente más simple: una llamada en vez de dos.
Y fíjense en la fila que casi se pasa por alto: el modo jerárquico — el que Laya me obligaba a usar — le resta 20 puntos de exactitud a Jev, lo duplica de lento y, peor aún, produce errores con confianza alta (fallos reportados con 0.91 y 0.97 de confianza). Si alguna vez dudan de que el diseño de la pregunta estructurada importa tanto o más que el modelo, este experimento natural es la evidencia.
El hallazgo accionable: una calibración que sí se puede operar
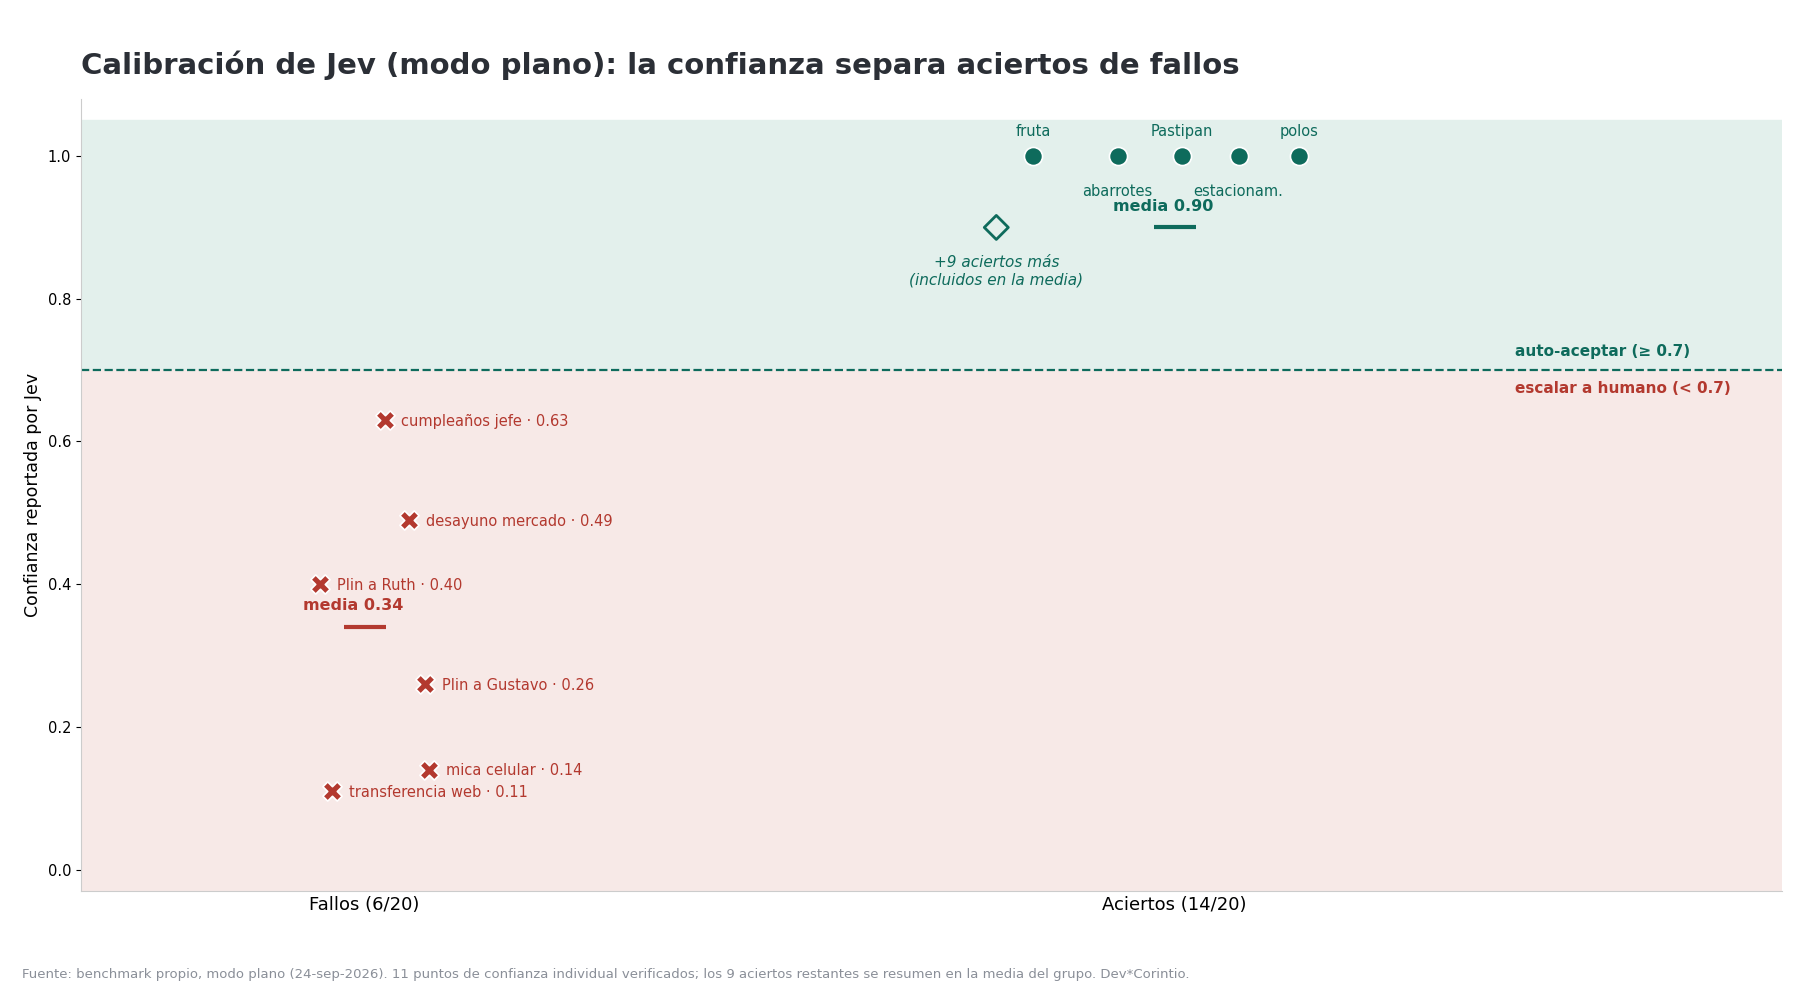
Con Laya ya había quedado impresionado con una cosa: el modelo fallaba mucho, pero lo admitía (confianza ~0.3 en los fallos). Jev lleva esa idea a territorio productivo. Con un umbral de confianza en 0.7, el modo plano se parte en dos zonas limpias:
- 12 decisiones se auto-aceptan → 100% correctas.
- 8 decisiones escalan a humano → ahí están los 6 errores reales, más 2 aciertos de baja confianza.
Traducción a producción: hoy, sin fine-tuning, sin un solo ejemplo de entrenamiento, puedo automatizar el 60% de la categorización con precisión perfecta y mandar el resto a Hermes o a mí mismo. Eso es exactamente el patrón act-or-escalate para el que están diseñados estos modelos. La diferencia con el modo jerárquico es abismal: allí la calibración se rompe, y un fallo con confianza 0.97 es el patrón más peligroso que existe en automatización — degrada tus datos convencido de que está bien.
Los 6 fallos: ambigüedad del dato, no del modelo
| Concepto | Categoría real | Jev predijo | Conf. |
|---|---|---|---|
| Almuerzo cumpleaños jefe | Salidas Individuales / Amigos Papá | Restaurantes & Salidas Familiares | 0.63 |
| Mica de celular | Artículos para el Hogar & Muebles | Mantenimiento & Reparaciones Hogar | 0.14 |
| Desayuno en el mercado de la casa | Panadería & Compras Diarias | Mercado de Frescos | 0.49 |
| Plin a Ruth | Mercado de Frescos | Pensión / Apoyo Mamá | 0.40 |
| Transferencia web/app | Mantenimiento & Reparaciones Hogar | Fondo de Emergencia | 0.11 |
| Plin a Gustavo | Snacks / Antojos del Hogar | Salidas Individuales / Amigos Papá | 0.26 |
Los seis errores comparten firma: transferencias P2P ("Plin a Ruth", "Plin a Gustavo") y conceptos vagos ("transferencia web/app"). Sin contexto, "Plin a Ruth" puede ser mercado, pensión o un préstamo — yo lo sé porque conozco a Ruth; el modelo solo ve el string. Ninguno de estos se arregla con un modelo más grande: se arregla con más señal en el dato (notas, contrapartida, reglas por cuenta). Hermes, mi LLM actual, enfrenta exactamente el mismo reto con estos casos.
Y los aciertos con confianza 1.00 cuentan la otra mitad de la historia: "Compra de fruta" → Mercado de Frescos; "Compra de abarrotes" → Supermercado Semanal; "Compra en Pastipan" → Panadería & Compras Diarias (comercio local peruano, correcto); "Compra de polos" → Ropa & Calzado Papá. Este último es mi favorito: entiende que "polos" son del papá, no de la familia entera — el modelo captó el ámbito personal de una taxonomía que nunca había visto.
El trade-off real: privacidad, no precio
Aquí está la parte que el titular "70%" no cuenta. Jev es una API cerrada y hosteada: cada transacción de mi familia sale de mi LAN hacia los servidores de TypeSafe AI. Laya, con todo y su 10%, nunca sacó un byte de mi casa. Esa es la decisión real de este artículo, y no tiene nada que ver con el accuracy.
El costo, en cambio, es casi una trampa de distracción: ~US$0.0004 por decisión. A cinco gastos al día — mi volumen real — son ~US$0.06 al mes. No es el precio lo que pesa en la balanza.
Lo que TypeSafe AI vende — fundada por Diogo Almeida (ex-OpenAI), lanzada el 15 de septiembre con una seed de US$40M liderada por DCVC — es una API con SLA y primitivas limpias: choice (hasta 255 opciones), score (escala 2–10), noul (probabilidad sí/no), 64k tokens por request, 1,200 req/min, a US$0.042 por millón de tokens de entrada con la salida gratis. Su claim estrella — 67.8% de acuerdo con GPT-6/Claude — corre en su propio set de evaluación, con metodología del vendor. Por eso este blog mide siempre con datos propios, aunque sean 20 filas.
La arquitectura que me llevo
- Jev plano con umbral 0.7 auto-acepta; debajo del umbral, escala a Hermes o a humano. 60% de automatización con precisión perfecta desde el día uno.
- Los 6 patrones de fallo se atacan con señal, no con modelo: notas obligatorias en transferencias P2P, reglas por cuenta, y eventualmente historial suficiente para que los conceptos vagos dejen de serlo.
- Laya sigue desplegado en mi servidor. Cuando el historial alcance para fine-tuning, re-evalúo con el mismo script y el mismo set. La revancha de la revancha, con fecha.
Las lecciones
- El benchmark viral mide la distribución del benchmark; tu problema real es otra distribución. Sí, otra vez.
- A veces lo que desbloquea la arquitectura simple no es el modelo sino la capacidad del producto: "hasta 255 opciones" eliminó de un plumazo la jerarquía que le costó 20 puntos de exactitud a Jev y la vida entera a Laya.
- La calibración es la feature. De nuevo. Un modelo que falla con 0.14 de confianza es operable; uno que falla con 0.97 es un incidente silencioso.
- El trade-off real no estaba en la tabla de resultados: estaba en dónde duermen tus datos.
- Los experimentos baratos pagan bugs reales: este benchmark me dejó al descubierto un bug de codificación en mi propio pipeline, antes de que corrompiera más datos.
El stack completo — NocoDB, FastAPI, Hermes, y ahora el clasificador de Jev — corre en (y parcialmente desde) mi homelab en Perú. El script del benchmark y los resultados están disponibles para quien quiera replicar el experimento. Si tú también mediste Jev o Laya contra un caso real, me encantaría leer tus números.